Ningún modelo de imagen conoce Roshar. Tuve que construir el mundo, entrenarlo como estilo propio, y después corregirlo con modelos locales
El camino completo de generar el mundo de Roshar para Verso: tres épocas de herramienta, un hallazgo sobre la fuerza del LoRA que cambió todo, y la regla que más uso al escribir un prompt — con el journey completo de una sola escena, en siete pasos.

Roshar (el planeta donde ocurre El Archivo de las Tormentas, la serie de fantasía de Brandon Sanderson que estoy leyendo — un mundo con su propia física, arrasado por tormentas periódicas que definen cómo crece cada planta y cada animal — coppermind.net/wiki/Roshar, la wiki de la obra), no está en el training data de ningún modelo de imagen. No hay caballos — hay chulls, axehounds, criaturas con caparazón sin equivalente fotográfico. La luz no es cálida: viene de gemas. La ropa sigue un pudor que no es el occidental: en la cultura vorin lo indecente es la mano, no el escote. Para Verso necesitaba cientos de imágenes de ese mundo, y ninguna herramienta tenía de dónde partir. Antes de poder generar nada consistente, tenía que construir yo mismo la referencia — y después, enseñársela a un modelo.
Ese camino tuvo cuatro tramos distintos, y cada uno resolvió algo que el anterior no pudo.
El punto de partida
Antes de generar en serio, armé la vara contra la que se compararía todo lo demás: cuatro escenas del pack original y un retrato de referencia — el personaje que serviría de benchmark durante toda la sesión. Sin eso, cada prueba posterior habría sido una opinión sobre qué "se veía bien", no una comparación real.
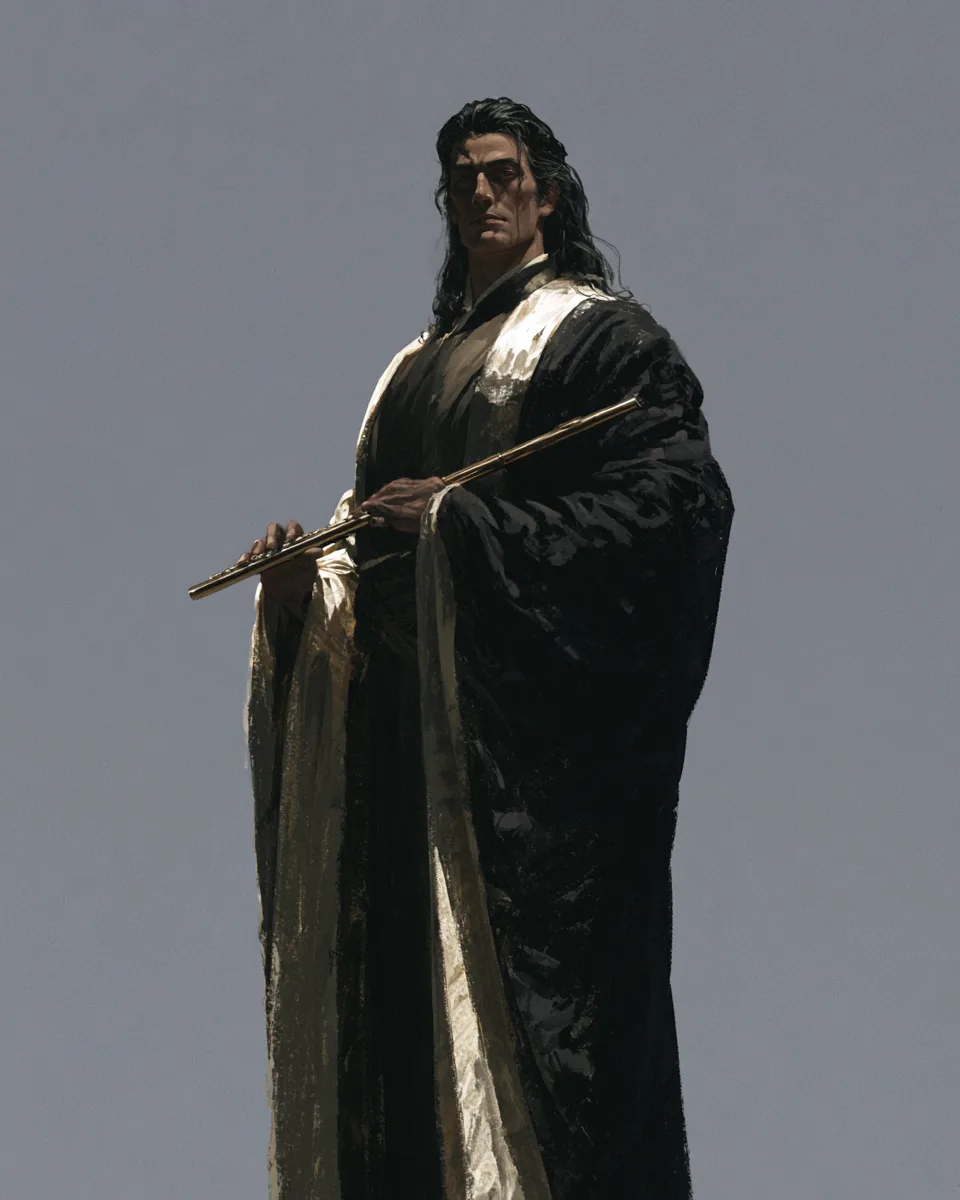
Construir el mundo y entrenar un estilo, a la vez
Con esa vara, generé 149 láminas con Midjourney (el generador de imágenes por prompt más conocido — midjourney.com) entre el 1 y el 6 de agosto, entrenando un perfil de estilo propio sobre la marcha. Esas 149 láminas cumplieron doble función: fueron el pack original de la app, y terminaron siendo el set de entrenamiento del LoRA (un método para afinar un modelo grande con relativamente poco entrenamiento extra, sin tocar sus pesos originales — huggingface.co/docs/peft) que vino después.
Fue en esa tanda donde aparecieron los errores de prompt más instructivos — uno de ellos, pedirle a Midjourney "una criatura del tamaño de un oso" y que dibujara un oso literal, con pelaje y hocico. Volveré a eso más abajo, porque terminó siendo la regla que más uso. Pero el límite real de esta época no fue de prompt: fue que el perfil entrenado no es portable ni exportable. Vive encerrado en la cuenta de Midjourney. El mismo personaje tampoco se sostenía entre generaciones — Kaladin salía distinto cada vez — y la safehand (la mano izquierda que las mujeres vorin llevan cubierta) salía siempre como un bulto de tela sin forma, en las tres herramientas que probé, no solo en esta.
Con un mundo ya construido pero un estilo que no podía llevarme a ningún lado, pasé a generar localmente.
Tres callejones sin salida, guardados a propósito
No repetir el camino vale tanto como saber cuál era el bueno, así que los tres quedaron documentados con sus dos lados:
Probé SDXL (Stable Diffusion XL, un modelo de imagen que corre en tu propia GPU en vez de en la nube de alguien más — huggingface.co/stabilityai) con un LoRA de lápiz de color bajado de CivitAI — de otro medio, no entrenado sobre lo mío. Perdía contra el control sin LoRA, y encima SDXL trunca el prompt a 77 tokens cuando los míos van de 100 a 200 palabras.
Probé IP-Adapter (una técnica para guiar la generación con una imagen de referencia, no solo texto) con un barrido de intensidad. A partir de 0.35, el encuadre de la referencia aplastaba la escena que estaba pidiendo por texto. La lección: IP-Adapter no transfiere estilo, transfiere composición.
Y probé guiar un modelo Turbo destilado con el guidance por default
(4.5): halos, contraste reventado, caras de muñeco. Bajarlo a 0.0 no solo se
veía mejor — tardaba la mitad, porque con guía el modelo corre el doble de
cálculo por paso. El problema nunca fue el checkpoint. Era cómo lo estaba
invocando.
El hallazgo que cambió todo: la fuerza del LoRA
Entrenando mi propio LoRA sobre las 147 láminas de Midjourney, con la fuerza en 1.0 —el default de la librería— todo salía desenfocado: caras que eran manchas, roca sin planos definidos. Y entre el checkpoint 150 y el 300 parecía empeorar, lo cual no tenía sentido con más entrenamiento.
Era falso. Cada 150 pasos el LoRA se vuelve más fuerte, no peor — se estaba midiendo siempre al tope de su fuerza, así que cualquier checkpoint se veía igual de desenfocado. Bajar la fuerza a un rango de 0.25 a 0.4 reveló la imagen que ya estaba ahí. Antes de llegar a eso descarté dos hipótesis con controles propios — que fuera subentrenamiento (entrenar más lo empeoraba) y que fuera desajuste de resolución (generar a la resolución exacta del entrenamiento no cambiaba nada). La lección que me llevo no es el número: es que una variable medida siempre al tope parece una variable rota.
Con eso resuelto, y encuadrando en busto para esquivar el problema de la safehand — cuanto más cuerpo entra en cuadro, más tiene que inventar el modelo, y más se equivoca — quedó una configuración estable: Krea 2 Turbo como base, mi LoRA a fuerza 0.25–0.4, 16 pasos, guidance en 0.0 porque es un modelo destilado, óleo para lo narrativo y grafito para lo enciclopédico. Mundo construido, estilo propio, corriendo en mi máquina.
La palabra que arrastra, en las dos herramientas
Cuatro veces, con sujetos completamente distintos, pedí algo solo para dar escala o contexto, y el modelo lo dibujó literal, como si fuera el sujeto principal:
| lo que pedí | lo que salió |
|---|---|
| "una criatura del tamaño de un oso" | un oso, con pelaje y hocico |
| un carro como parte del decorado | un caballo que nadie pidió |
| "atardecer rojo sangre" + "abismo" | un cañón apocalíptico con volcán |
| una lámina en grafito que nombraba colores | salió a color |
Mi primer instinto, las cuatro veces, fue insistir: más énfasis, mayúsculas, más negativos. No funcionó ni una vez. Lo que funcionó fue borrar la palabra y decir la misma idea sin nombrarla — "más alto que el hombre" en vez de "del tamaño de un oso"; describir el encuadre en vez de repetir "abismo". La regla quedó así: cuando algo no sale, no añadas énfasis — busca la palabra que arrastra y quítala.
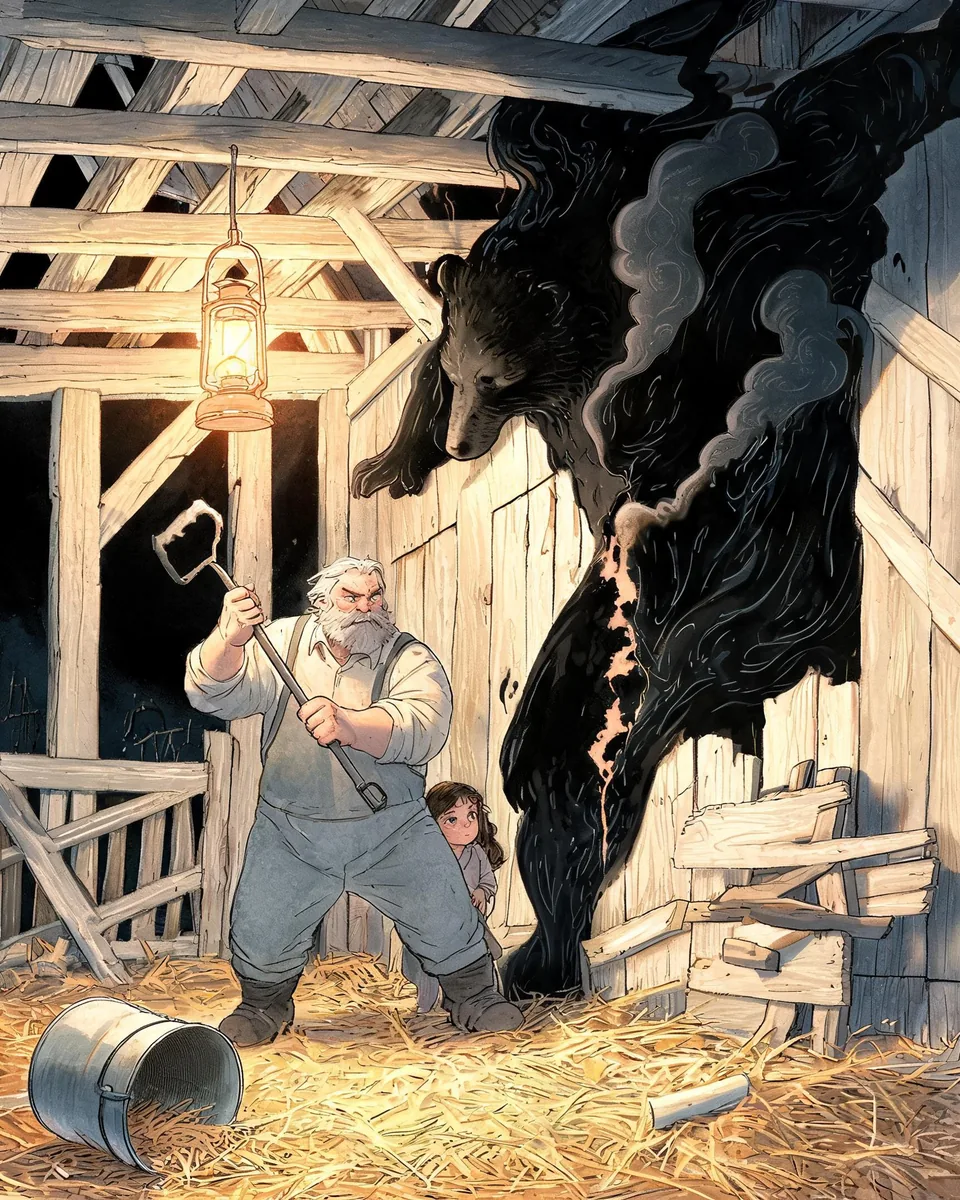
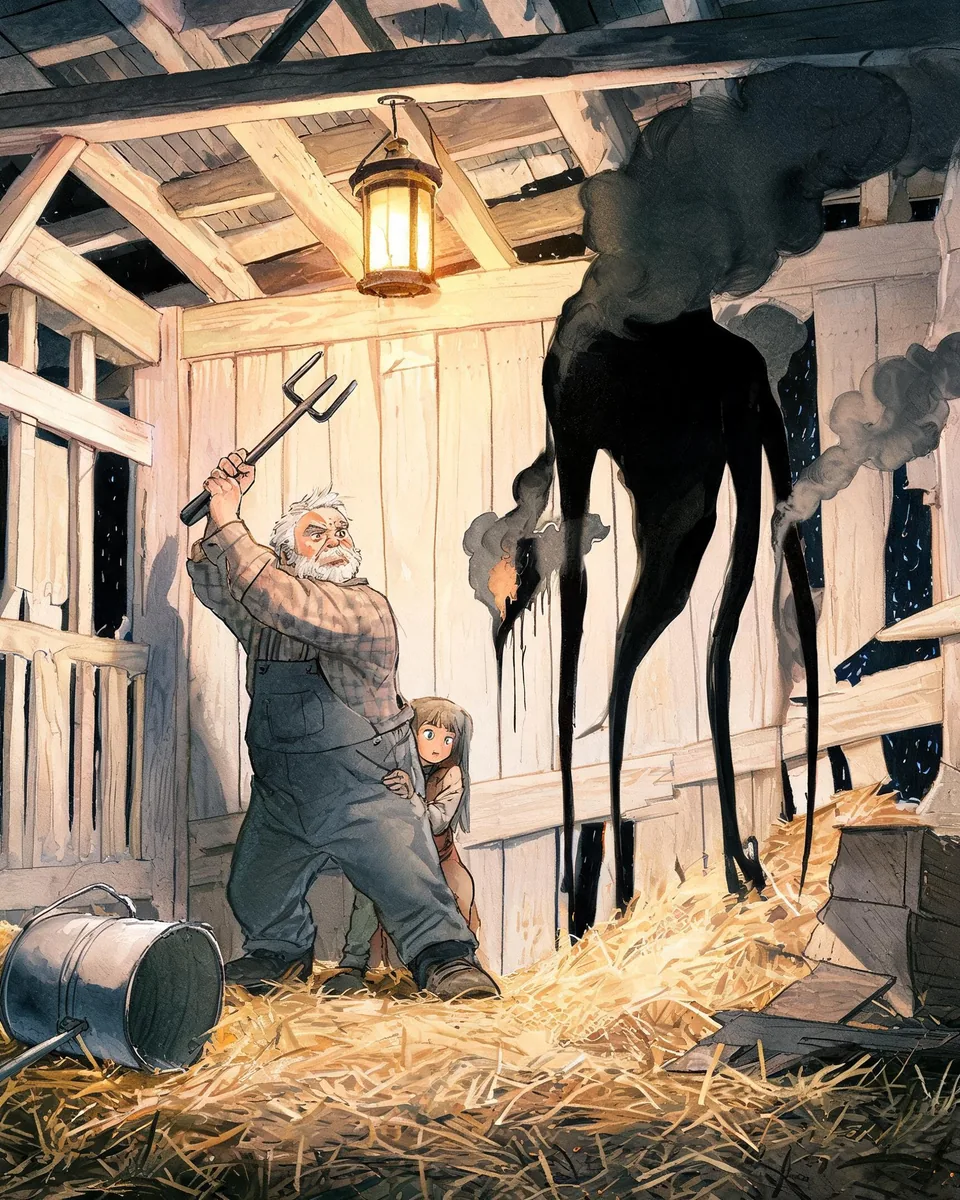
De los tres errores más citados, el "antes" no se había conservado — se regeneraba encima del arreglo. Reconstruirlos con "el prompt original" habría sido falso: no había semilla guardada, y el perfil de Midjourney con el que salieron no es exportable. Así que invertimos el arreglo documentado sobre el prompt que sí quedó, y generamos los dos lados con la misma herramienta, cambiando solo la palabra. Dos de tres reprodujeron limpio — el oso volvió a ser oso, y el volcán mostró que el arreglo no había cambiado ni una palabra de contenido, solo el encuadre. El tercero no reprodujo, y ahí está el matiz que le faltaba a la regla: la palabra que arrastra viaja entre herramientas, pero hacia dónde tira una herramienta por defecto es de esa herramienta, y hay que medirlo en cada una antes de copiar negativos de la anterior.
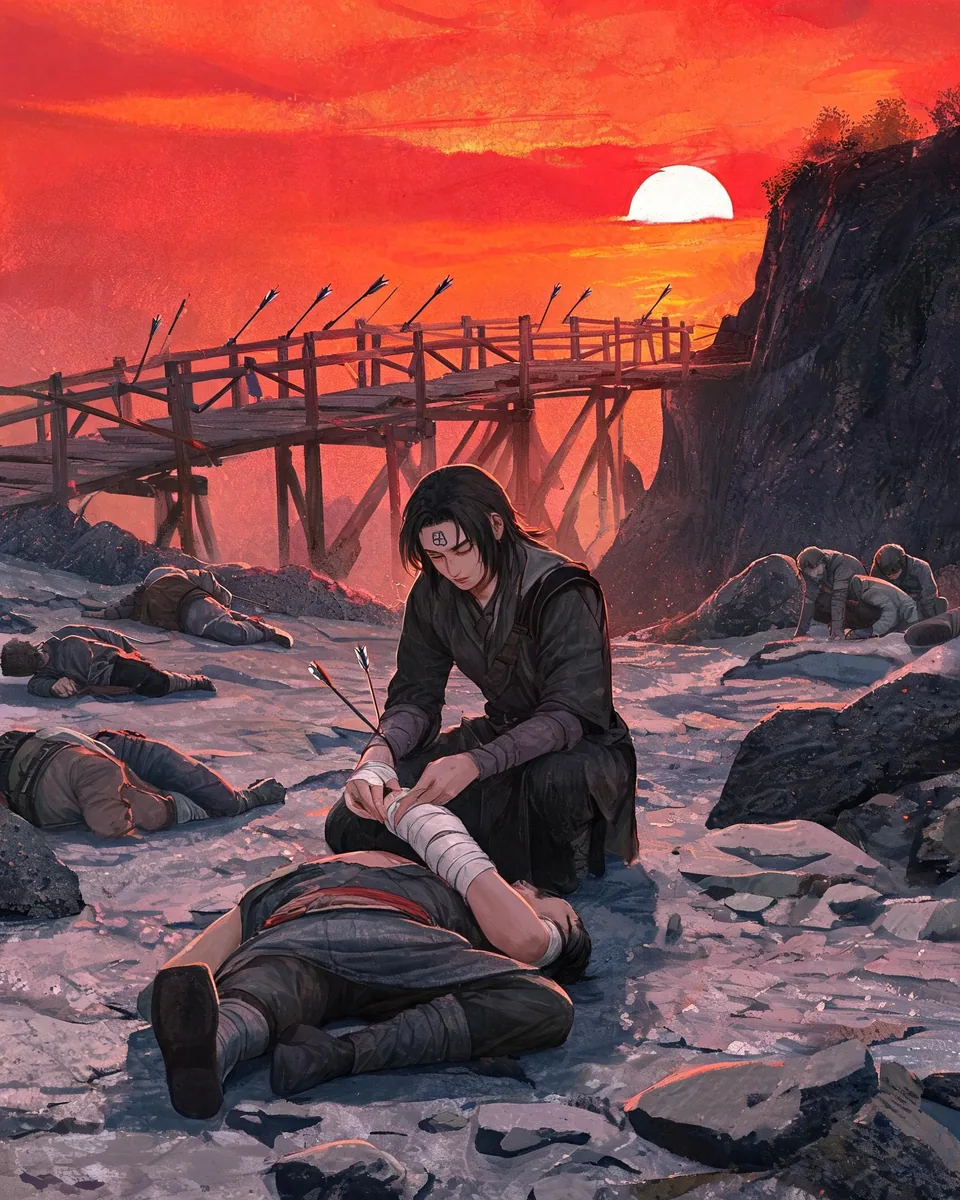
La última época: probar si la nube resolvía lo que faltaba
Con el pipeline local estable, pausé para evaluar si algún servicio de nube resolvía lo único que seguía sin cerrar: identidad de personaje, lore y alma de estilo, los tres a la vez.
Seedream (modelo de generación por referencia de BytePlus) con referencias suaves resolvió algo que ninguna herramienta anterior había logrado: la marca sobre la piel, pintada como cicatriz creíble y no como texto o números. Y para láminas de una sola entidad —una hoja esquirlada, un chull— con una sola referencia naturalista bastaba. Lo que no resolvía era el alma en escenas narrativas complejas: composición y canon correctos, pero caído a ilustración digital genérica.
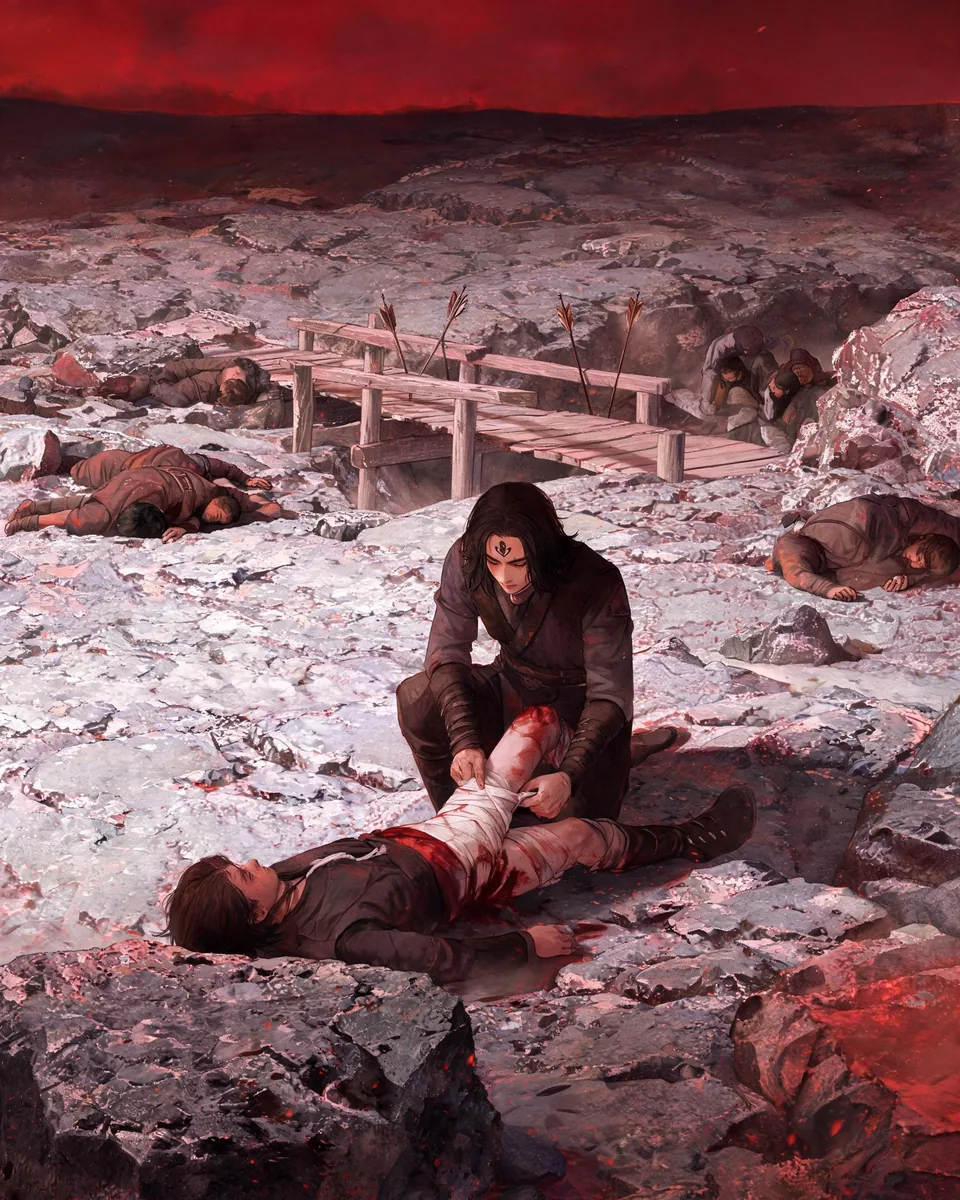
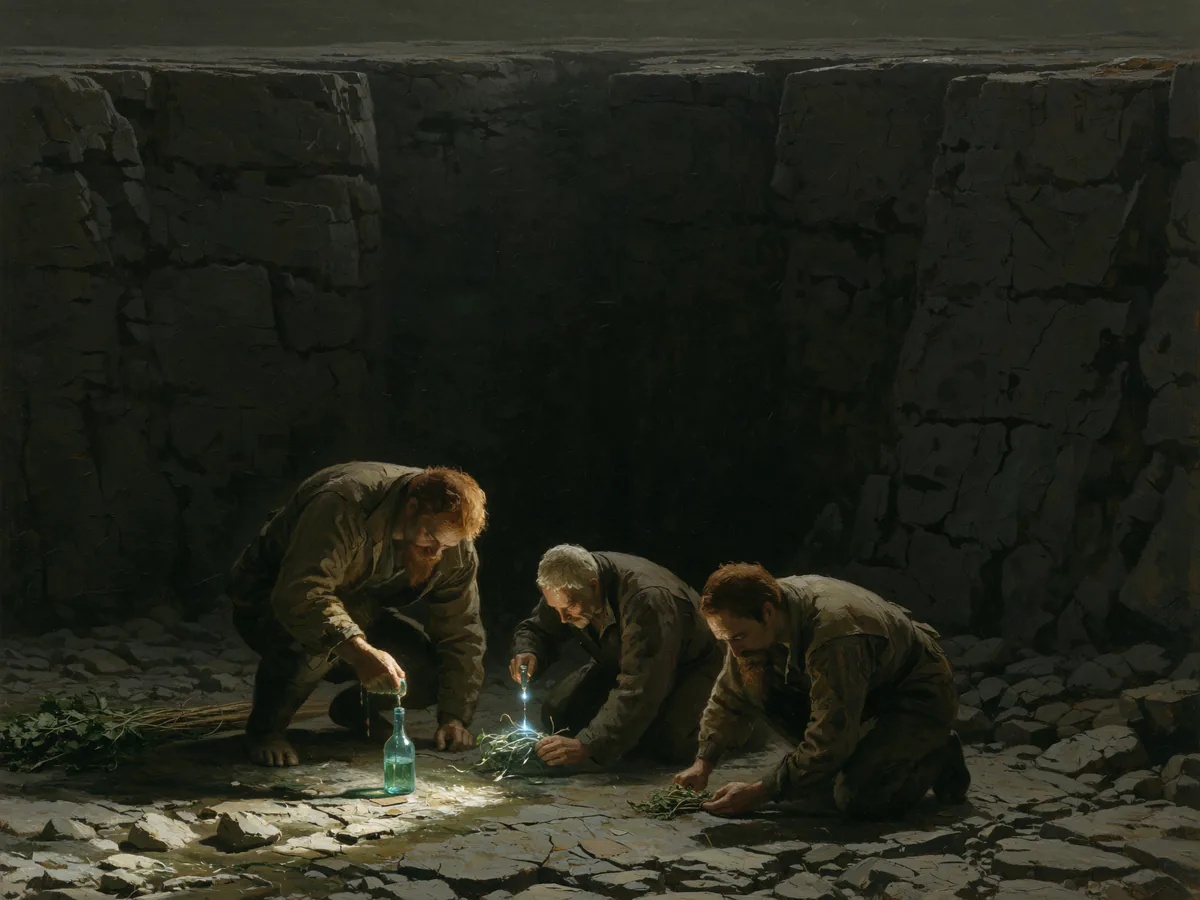
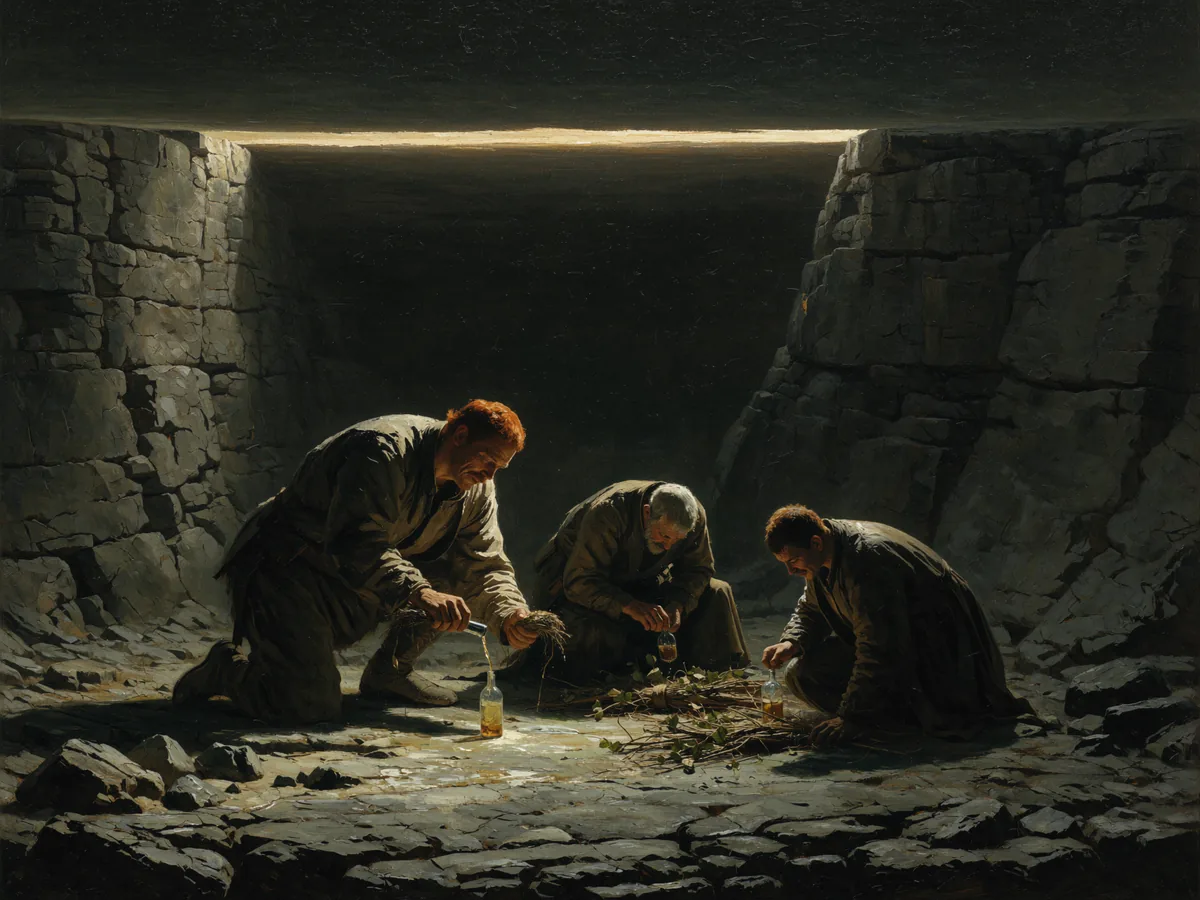
Higgsfield Soul (entrenamiento de un estilo propio persistente, no solo referencia por imagen) cerró justo esa brecha: óleo de verdad —empaste, claroscuro— en una escena de tres figuras, donde la referencia suave se caía. Lo que no resolvía era la marca (la escribía como texto) ni la consistencia de cara entre generaciones. Más abajo, en el camino completo del Abismo del Honor, se ve exactamente esa escena.
El veredicto, después de tres épocas: ningún servicio único lo resuelve todo. Un estilo entrenado sostiene el alma en lo complejo porque vive en los pesos, no en el prompt. Una referencia suave basta cuando el sujeto es simple y el ancla puede mandar. Lo que ninguna de las dos resuelve —el matiz exacto de una expresión, la identidad de cara entre escenas— se anota como techo del modelo, no se persigue a fuerza de GPU.
Un camino completo, sobre un solo lugar
Todo lo de arriba pasó disperso entre docenas de escenas distintas. Hay una sola localización, el Abismo del Honor, que atravesó las cinco herramientas y las tres épocas completas — y verla en fila es más claro que cualquier resumen.
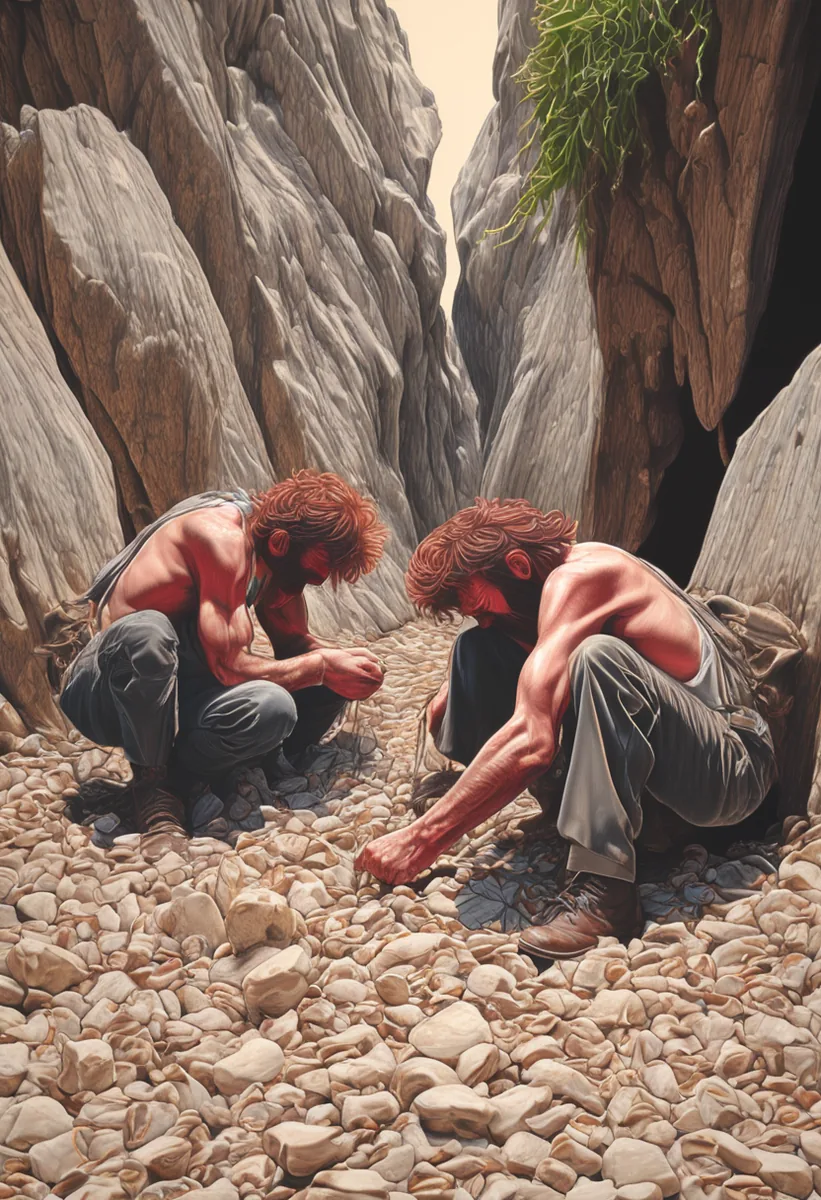
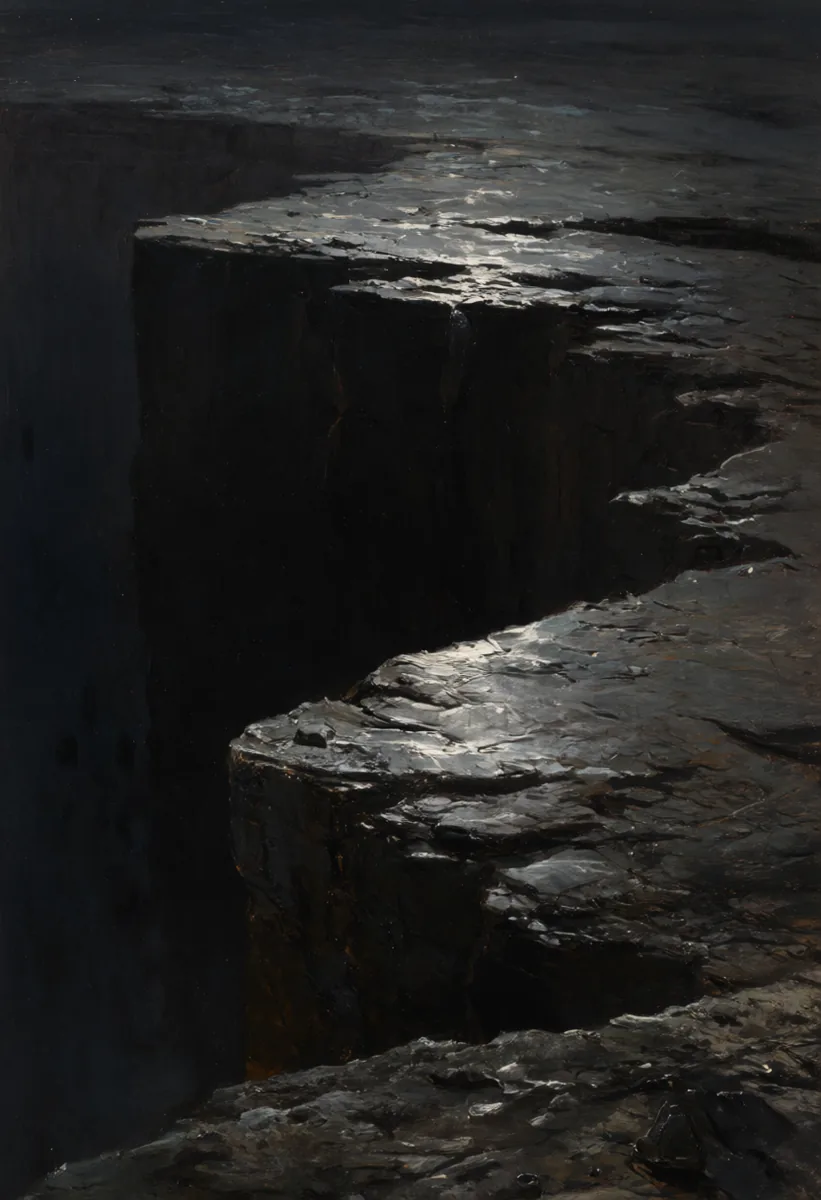
Antes de mirarla, un matiz que cambia lo que estás comparando: los pasos 1 y 5 son el lugar — una lámina del sitio, sin figuras. Los otros cinco intentan la cuadrilla dentro de él — el grupo de personajes buscando algo en el fondo del abismo. No es el mismo encuadre en los siete. Lo que sí es igual es el sitio y la intención, y esa es la comparación que importa.
1 · Midjourney, el punto de partida. Gouache y acuarela, el registro original del pack. La vara: todo lo que vino después intentaba llegar aquí sin depender de una nube cerrada, con un perfil que no se puede exportar.
2 · SDXL con un LoRA ajeno — el medio equivocado. Probé un LoRA de lápiz de color bajado de una galería pública. Las figuras salen sobrerrenderizadas, y el material es otro: se ve trazo de lápiz donde debía haber empaste de óleo.
3 · SDXL sin LoRA, el control — y aquí está el dato que importa. Tres ancianos genéricos, sin nada del mundo del libro. Pero puesto al lado del paso 2, el control está más cerca de mi registro que la versión que se suponía mejorada.
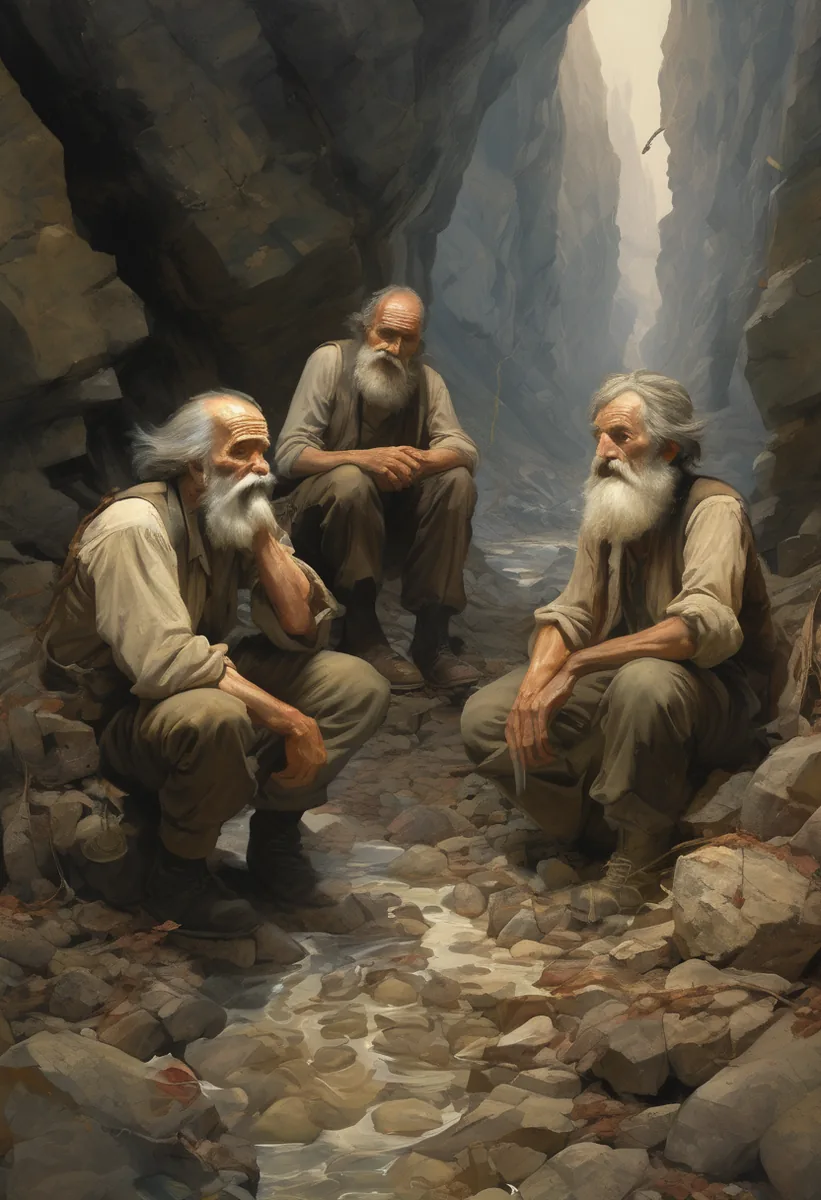
Ese control es la razón por la que descarté SDXL — no la calidad de ninguna de las dos versiones. Sin generar el control, el paso 2 habría parecido simplemente "mejorable", y me habría pasado días afinándolo en la dirección equivocada. Es la misma lección que la palabra que arrastra, un nivel más arriba: el instinto es afinar lo que ya tienes; lo que funciona es medir contra un control, y si el control gana, tirar el intento entero.
4 · Krea 2 sin entrenar — el callejón más raro de todos. Sin ningún estilo propio cargado, le pedí lo mismo que a las demás herramientas. Salió arte naíf: figuras planas y desnudas recogiendo plantas en frascos, paleta verde de estilo folk. (Van sin ropa — nada explícito, es el registro de la pintura naíf, y lo dejo porque el fallo de estilo es justo lo instructivo.)
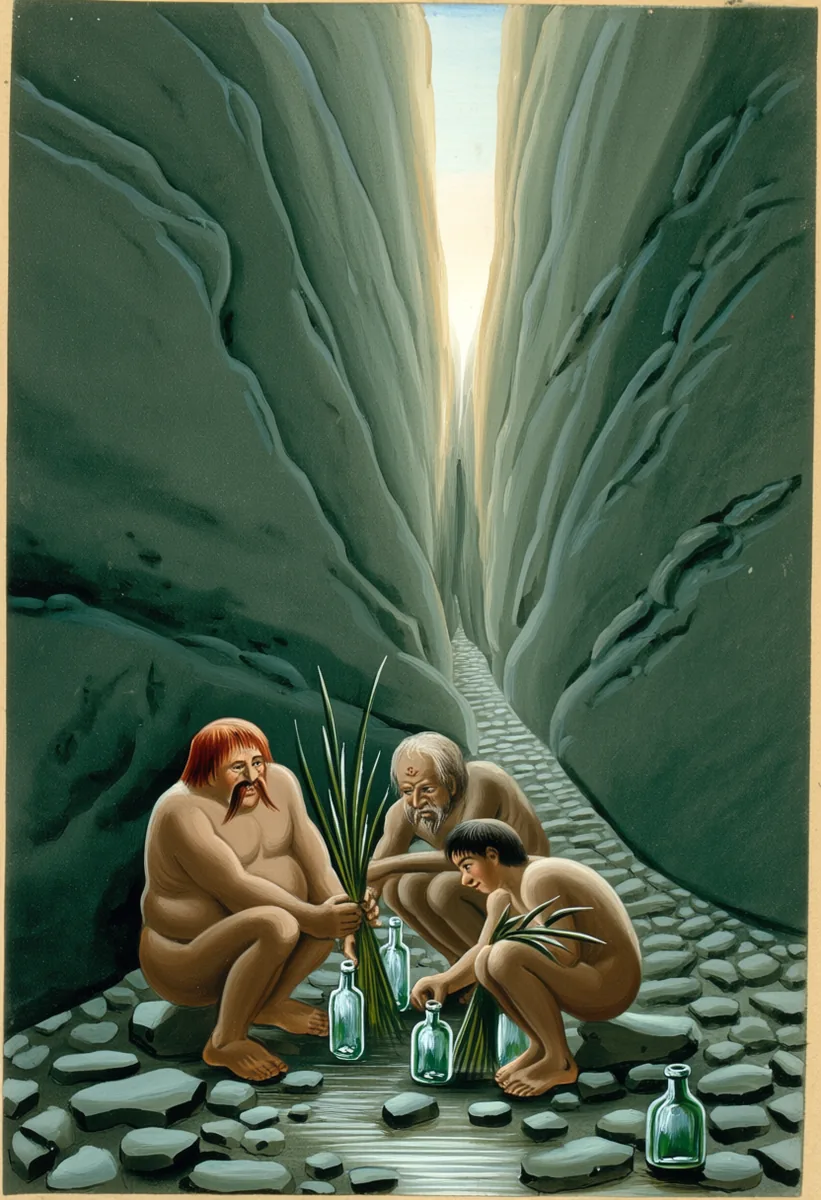
No tiene nada que ver con lo que pedí, y por eso está aquí: es la mejor demostración de todo el proyecto de que un modelo base no sabe nada de tu mundo por mucho que se lo describas en el prompt. El estilo no se pide. Se trae — entrenado, o cargado en los pesos.
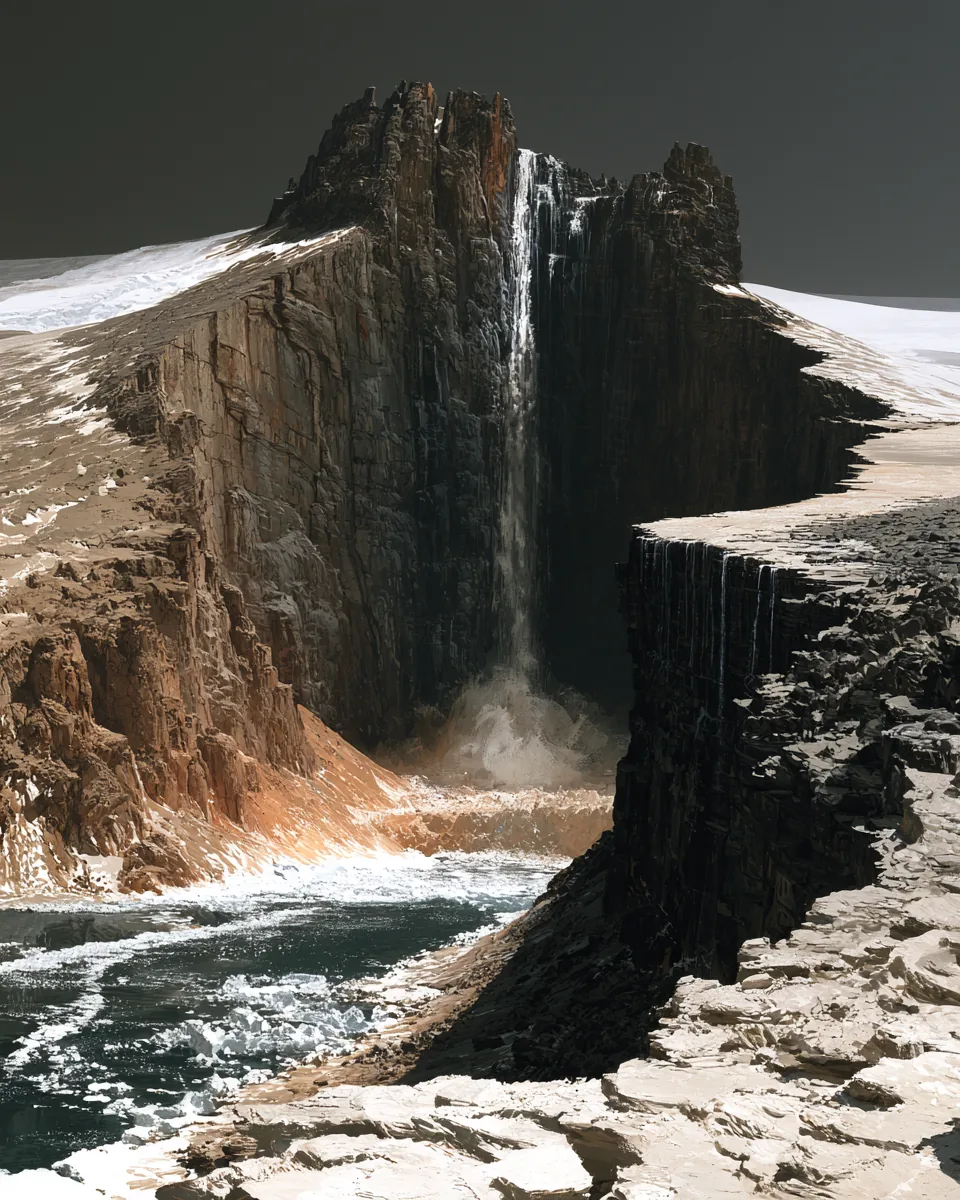
5 · El mismo Krea 2, con mi LoRA — lo que quedó en pie. Nada cambió del modelo base entre el paso 4 y este. Cambió que ahora carga pesos entrenados sobre mis propias 147 láminas. Óleo de verdad: el abismo como masa de roca y sombra, sin figuras.
6 y 7 · Higgsfield Soul — el estilo entrenado en una escena compleja. La cuadrilla de vuelta, ahora con luz dirigida y empaste real. Todo aguanta un plano de paisaje vacío; lo que separa a las herramientas es una escena con tres figuras haciendo algo — comparado con el paso 2, la distancia es la respuesta completa a por qué terminé aquí.
Las siete, en secuencia, están también en 09-un-camino-completo del repo.
Lo que dejo abierto
El repo completo — las tres épocas, los tres callejones sin salida, el catálogo de errores de prompt y el experimento reconstruido — está publicado en github.com/andyeswong/verso-imagenes, porque lo útil no fue el resultado final: fue entender por qué fallaba cada intento. Un archivo del experimento de referencias quedó en cero bytes en el origen y no se pudo recuperar — queda anotado en vez de disimulado.
El texto del cuaderno es CC0: las reglas, los diagnósticos, los prompts, cógelos y úsalos. Las imágenes ilustran un mundo con derechos y están ahí como documentación técnica del proceso, no para reutilizar.
Con esto cierro la serie: la app que resuelve cómo leo, los packs que explican cómo se arma el material, y esto — el mundo que hubo que construir, entrenar y corregir tres veces antes de que existiera de verdad.
artículos_relacionados

Diseñé un schema escalable y auditable para los mundos de mis libros. Nunca tuve que cargar un libro completo de una sola vez
Cómo diseñé el formato de packs de Verso — JSON auditable en vez de una base de datos, y un gate de spoilers que se resuelve comparando dos enteros — para que crezca capítulo a capítulo sin arriesgar nada de lo ya leído. Con pack de Drácula descargable de referencia.

Cada vez que le pedía a ChatGPT que me mostrara el mundo del libro, perdía lo que había generado el día anterior
Construí Verso, un lector de worldbuilding que corre al lado del libro que estoy leyendo, porque ChatGPT perdía lo que generaba y no respetaba mi progreso de lectura.

Agentes de voz: la voz es lo que menos importa
Le metimos voz en tiempo real al moderador de Quorum. El bug que casi tira el proyecto no fue de audio ni de latencia — fue de memoria, protocolo e idioma. El camino completo, con lo que sirvió y lo que no.
posts_recientes
Diseñé un schema escalable y auditable para los mundos de mis libros. Nunca tuve que cargar un libro completo de una sola vez
1 sept 2026
Cada vez que le pedía a ChatGPT que me mostrara el mundo del libro, perdía lo que había generado el día anterior
1 sept 2026
Agentes de voz: la voz es lo que menos importa
31 ago 2026
Cuando mis directores no se ponen de acuerdo, no meto una IA que decida. Meto cuatro que los obliguen a decidir
31 ago 2026